借助ai批量翻译书籍
保研结束,可算有了去处,虽然不知道以后的生活会如何,但是至少现在是终于有时间看书学习了。现在ai的能力有了很大的提高,但是让我非常焦虑的一个点是,ai的知识实在是过于渊博了,很多时候不是我去使用ai,而是ai去驱使我去干活儿。那么如果能够提高一点自身的知识的水平,或许能更好地使用ai。因此看书学习势在必行。
本人的英文水平实在糟糕,看纯英文的教材根本看不懂。很多书的中文翻译版也很难找到(表扬机械工业出版社,此社的书籍引进非常及时)。但是最大的问题是中文出版的翻译版本的教材的翻译其实不一定准确,而且也没有英文对照,学知识当然是可以的,但是长此以往,英文水平也得不到提高。学术界的通用语言是英文,那么学知识的时候最好能接触到某一个学术概念的英文的名称,这样看文献的时候会熟悉一点,不至于过于陌生。
PDFmathTranslate
翻译使用的开源项目是pdfmathtranslate ,在github上的开源地址是https://github.com/PDFMathTranslate/PDFMathTranslate
这个项目以前超级火,因为它保留了原本数学公式的排版格式。最重要的是它保留了排版位置,可以非常方便地实现中英文对照着看,下面的图是翻译成品的一个例子:
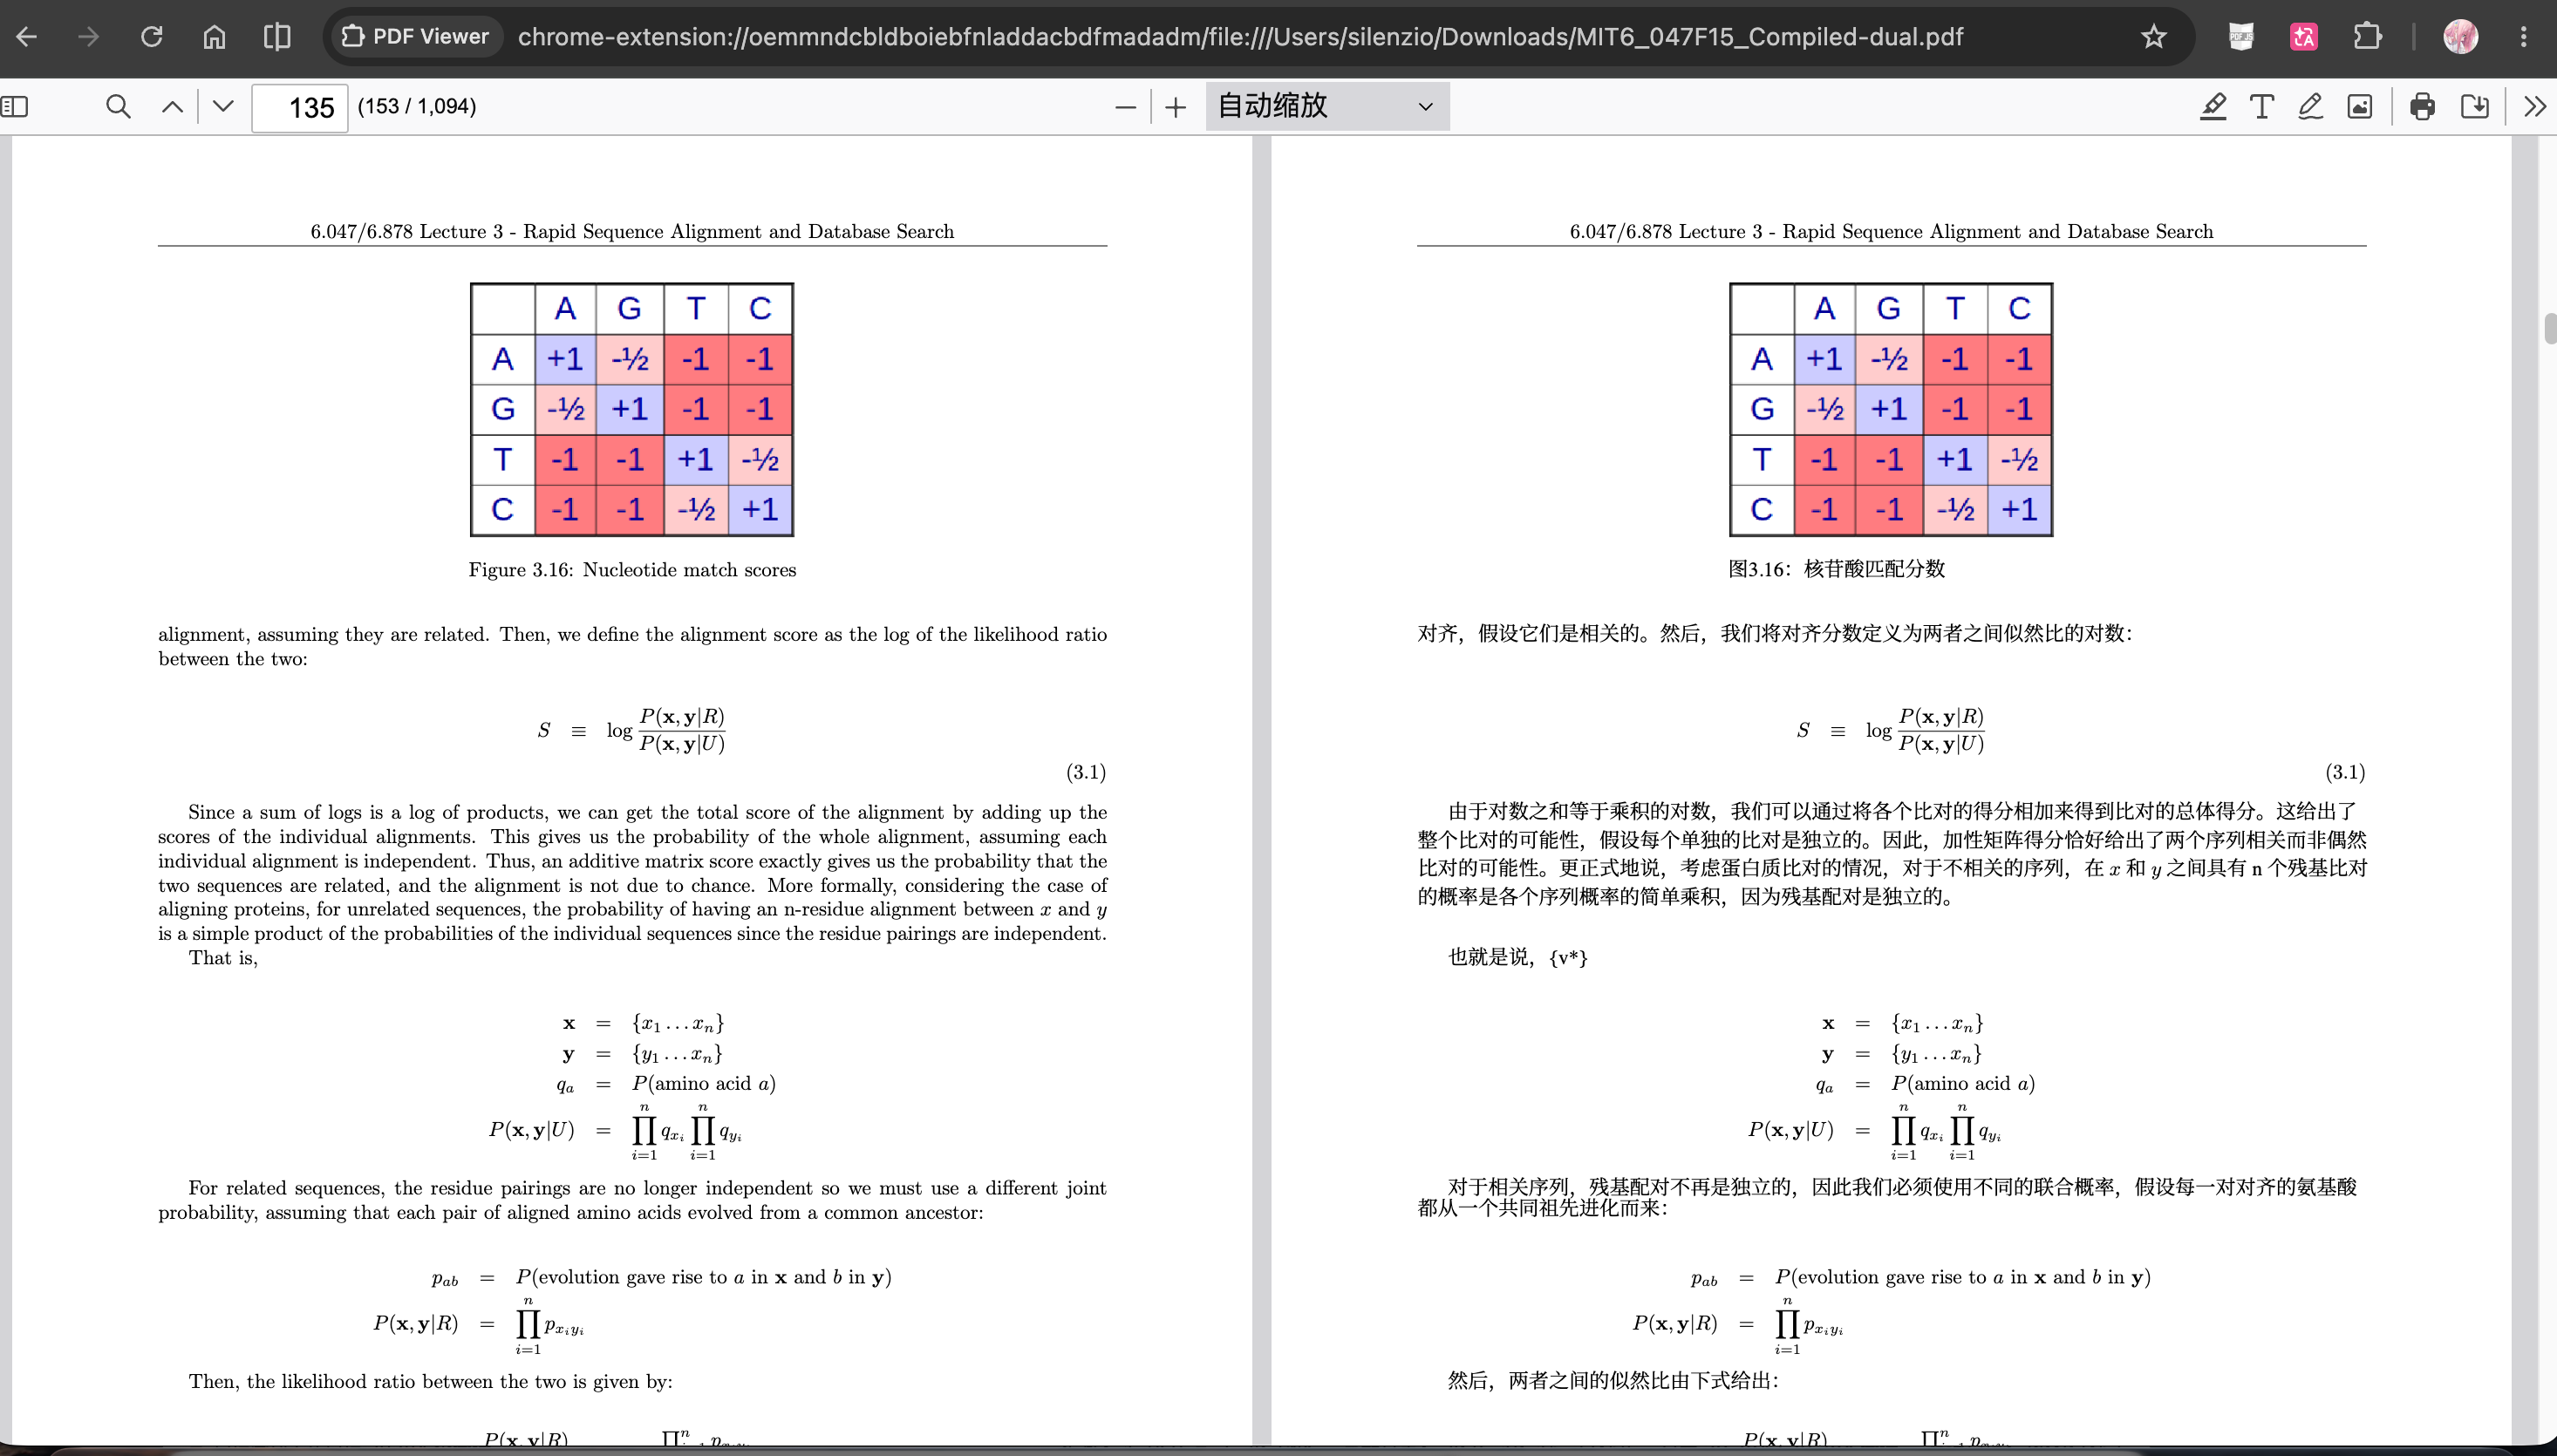
可以看到,翻译出来的成品的排版基本遵从了原书籍(这本书是MIT的计算生物学的教材,搜其中的书名就可以很方便地找到)的排版的格式。这样显得非常清晰易读(这里有一个改进的空间,可以很清楚地看到,排版出来的中文段落之间的间隙比较大,部分是由于中文的信息密度比英文高造成的那么如果把字体放大一点,通过全局的间隙算一个最优的字体放大的幅度,可以使中文的页看起来排版更优雅一些)。
这个项目提供了google和bing的翻译服务,但是批量调用我这里的ip被限制掉,不是特别方便,此外其速度也比较慢。那用llm来翻译如何呢,那当然是很不错的了,翻译质量一般情况下是比谷歌翻译强一点点的。当然我现在不知道谷歌的翻译服务现在是否是走大模型提供的。
首先openrouter有很多免费的模型提供服务:
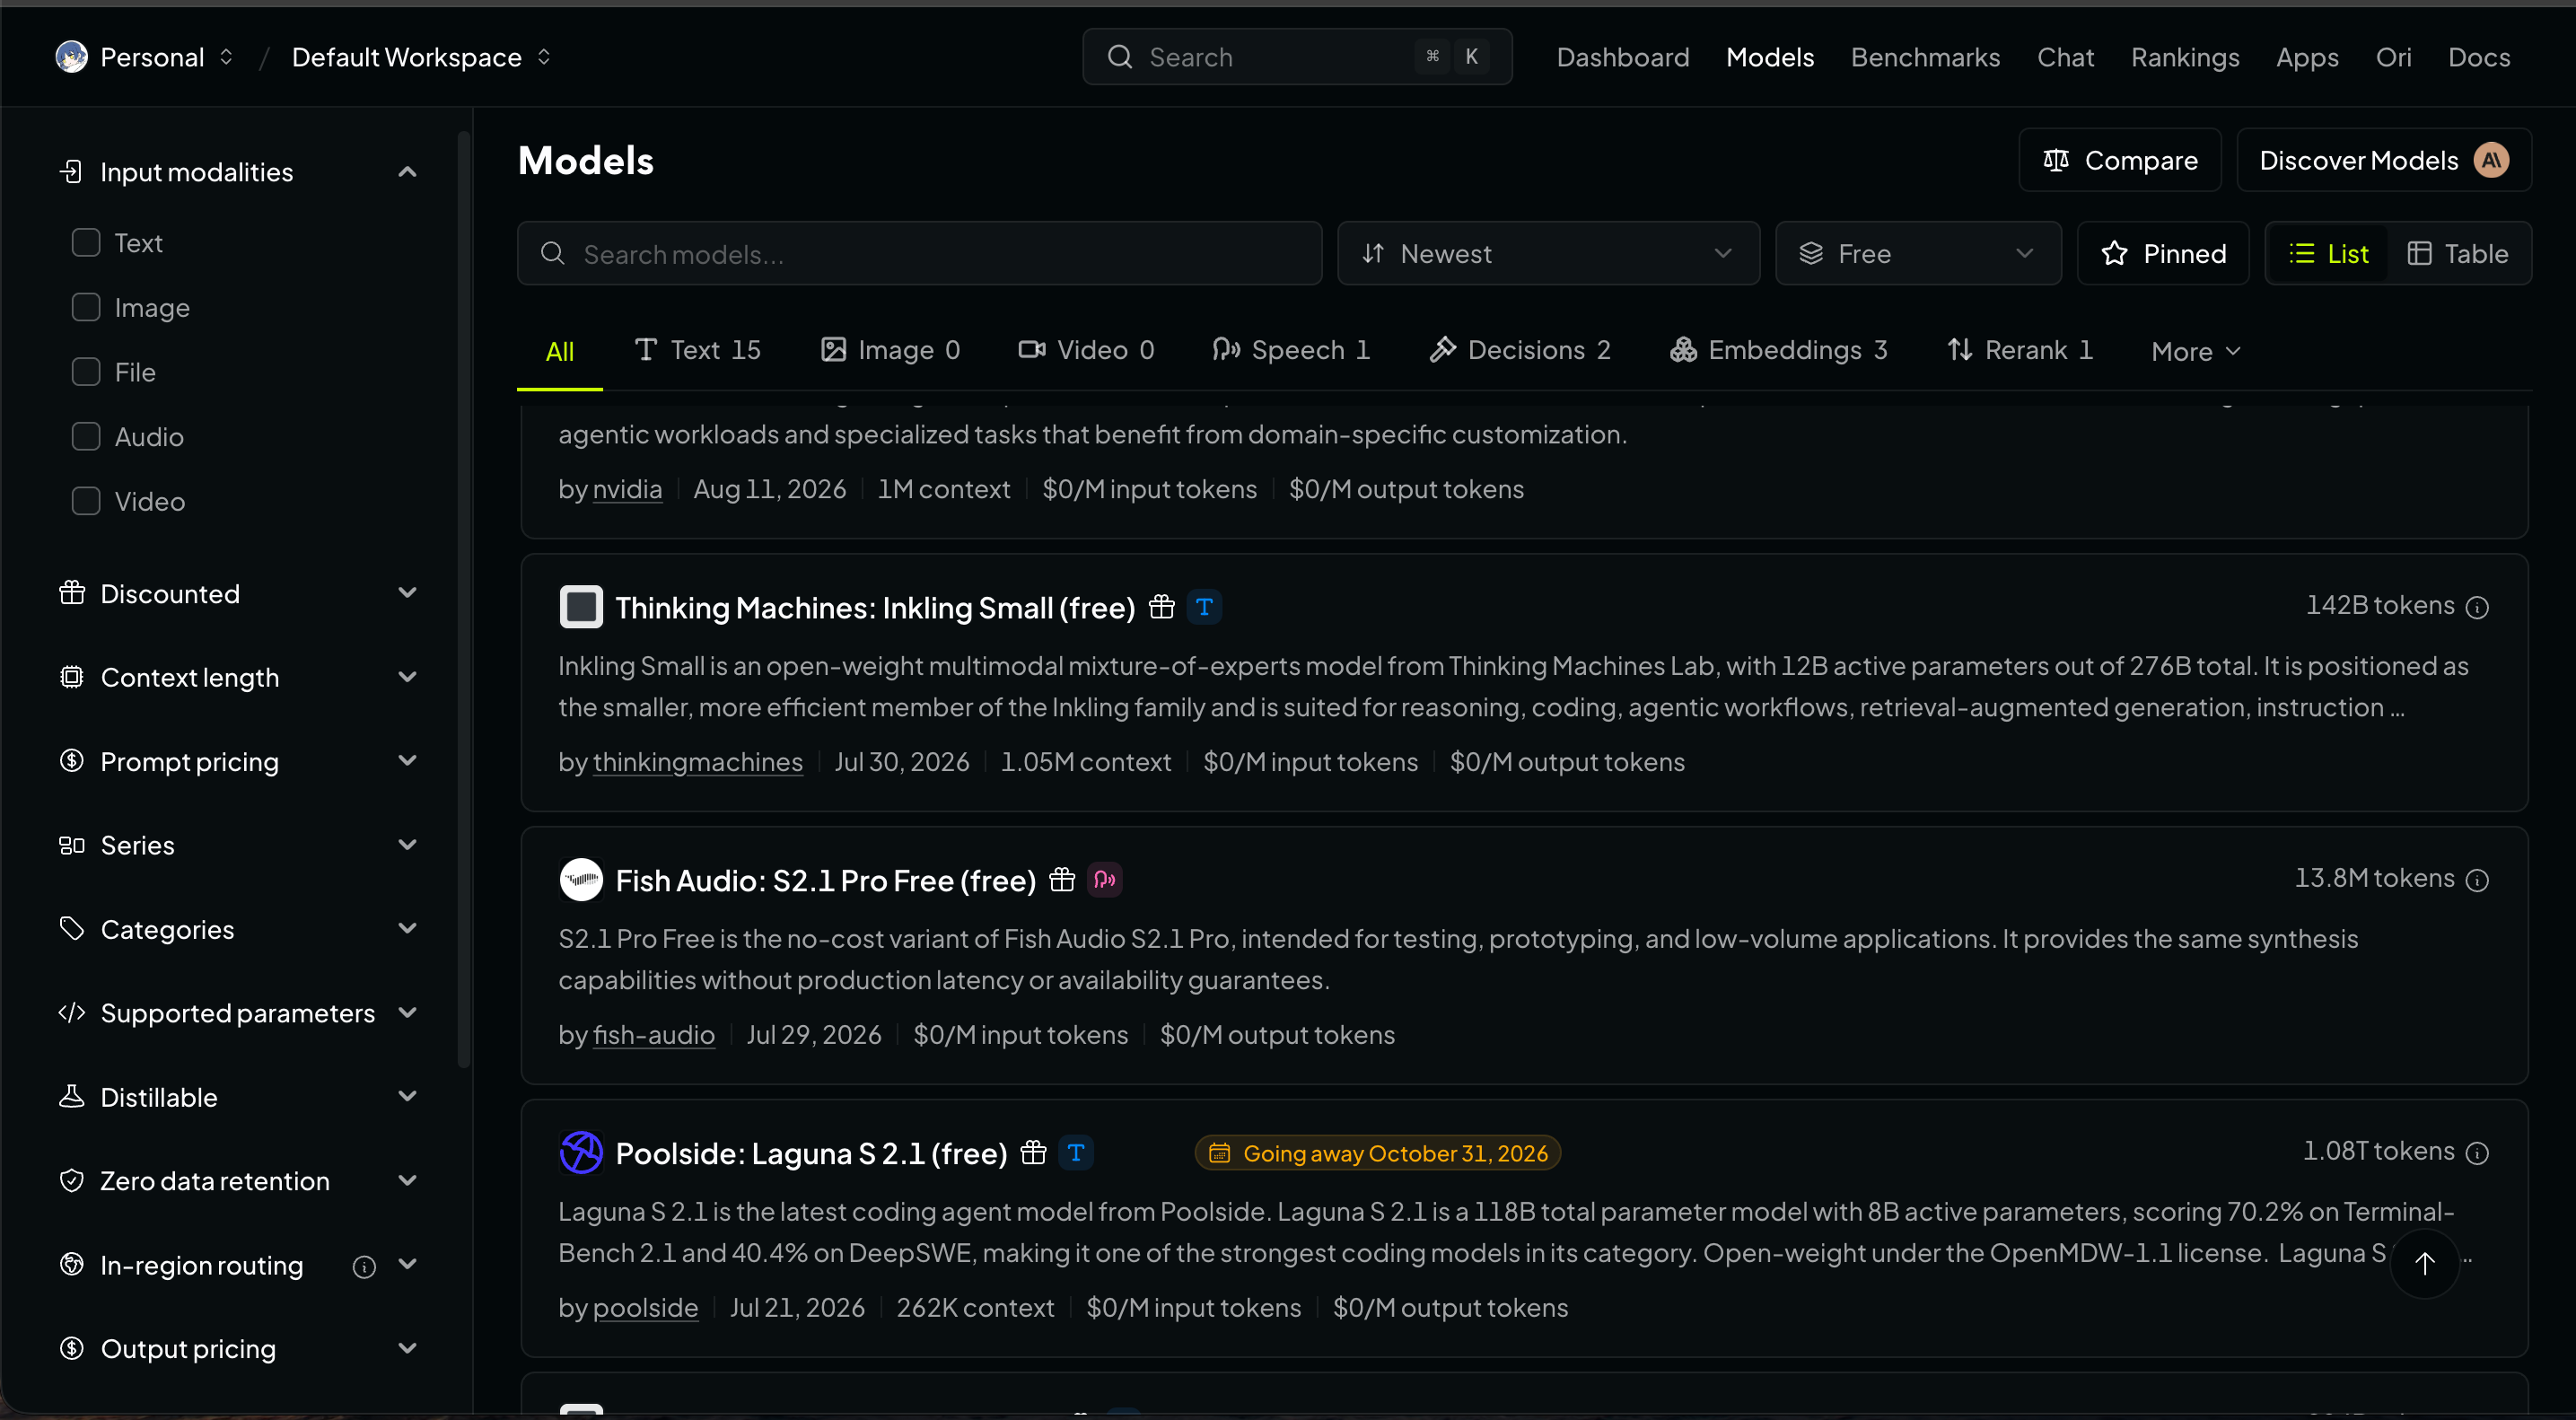
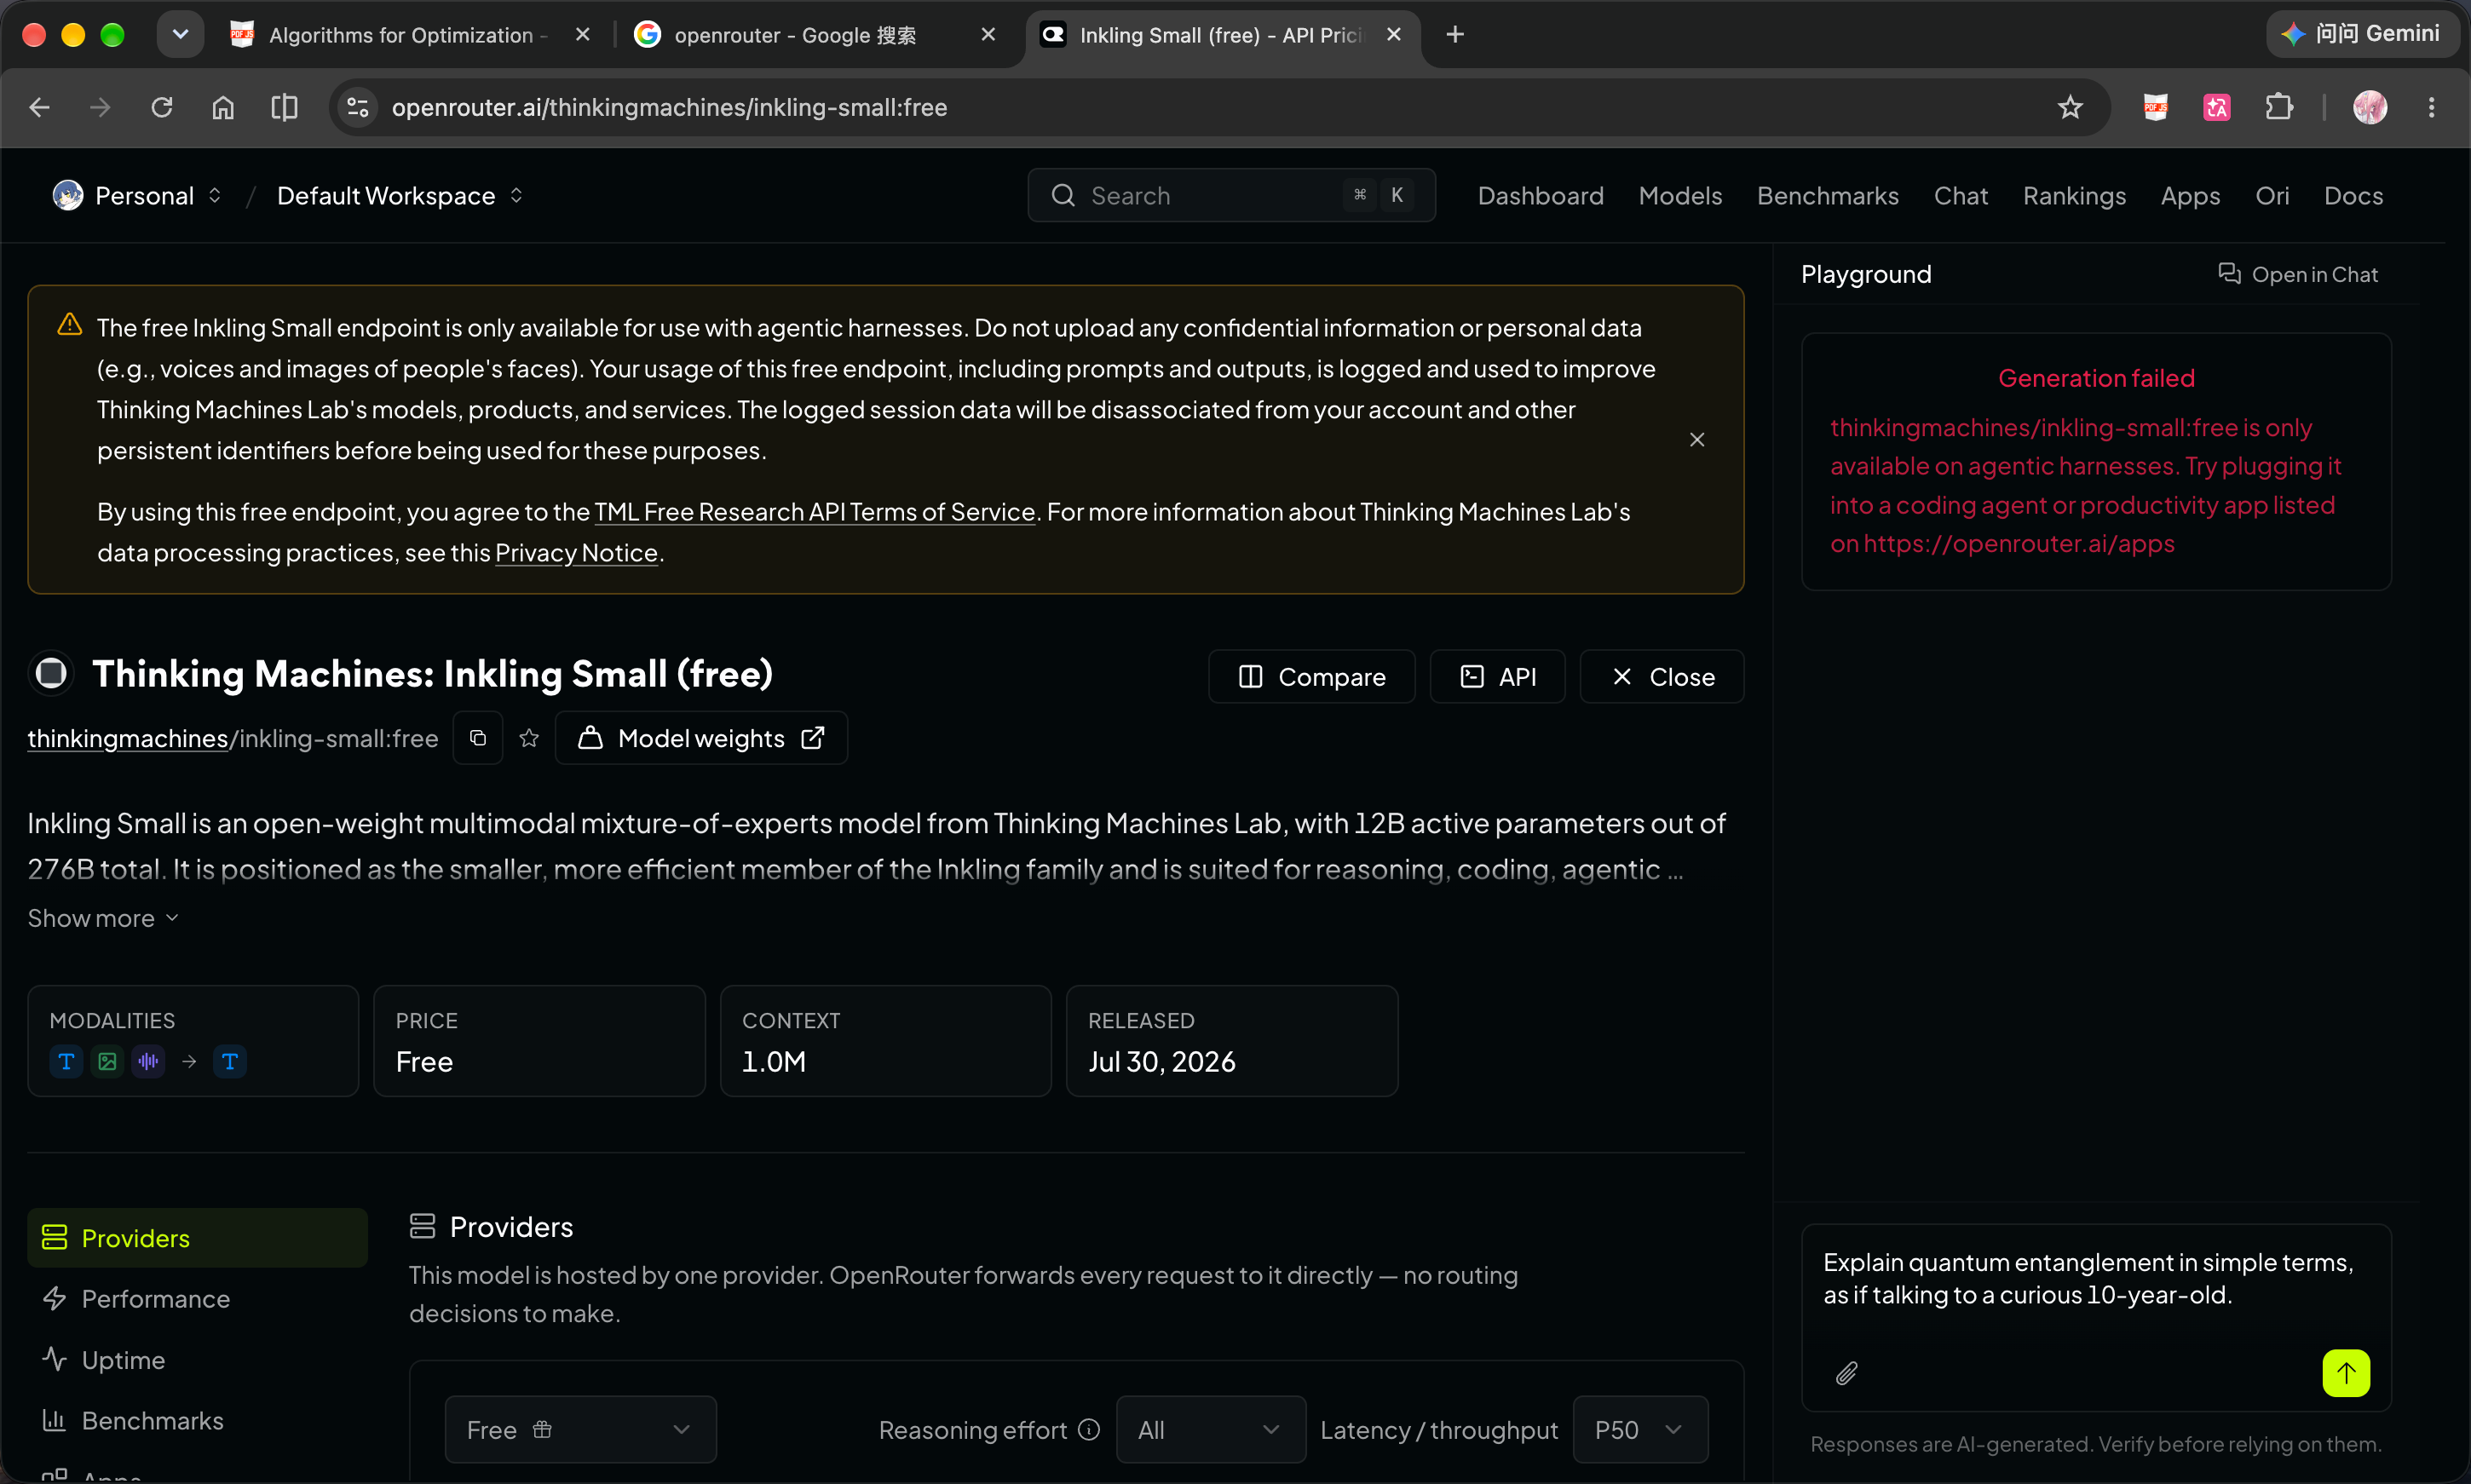
但是这些模型有些声明只能通过agent去调用他们:
转换网关
为了能够薅到这些模型,势必要写一个转换的网关,把请求包装成agent的样式。这个网关也带来了另外一个好处,可以保证翻译软件里所填的地址不用频繁变动。openrouter请求的格式如下:
1 | |
而我们的翻译服务只提供这样的接口:
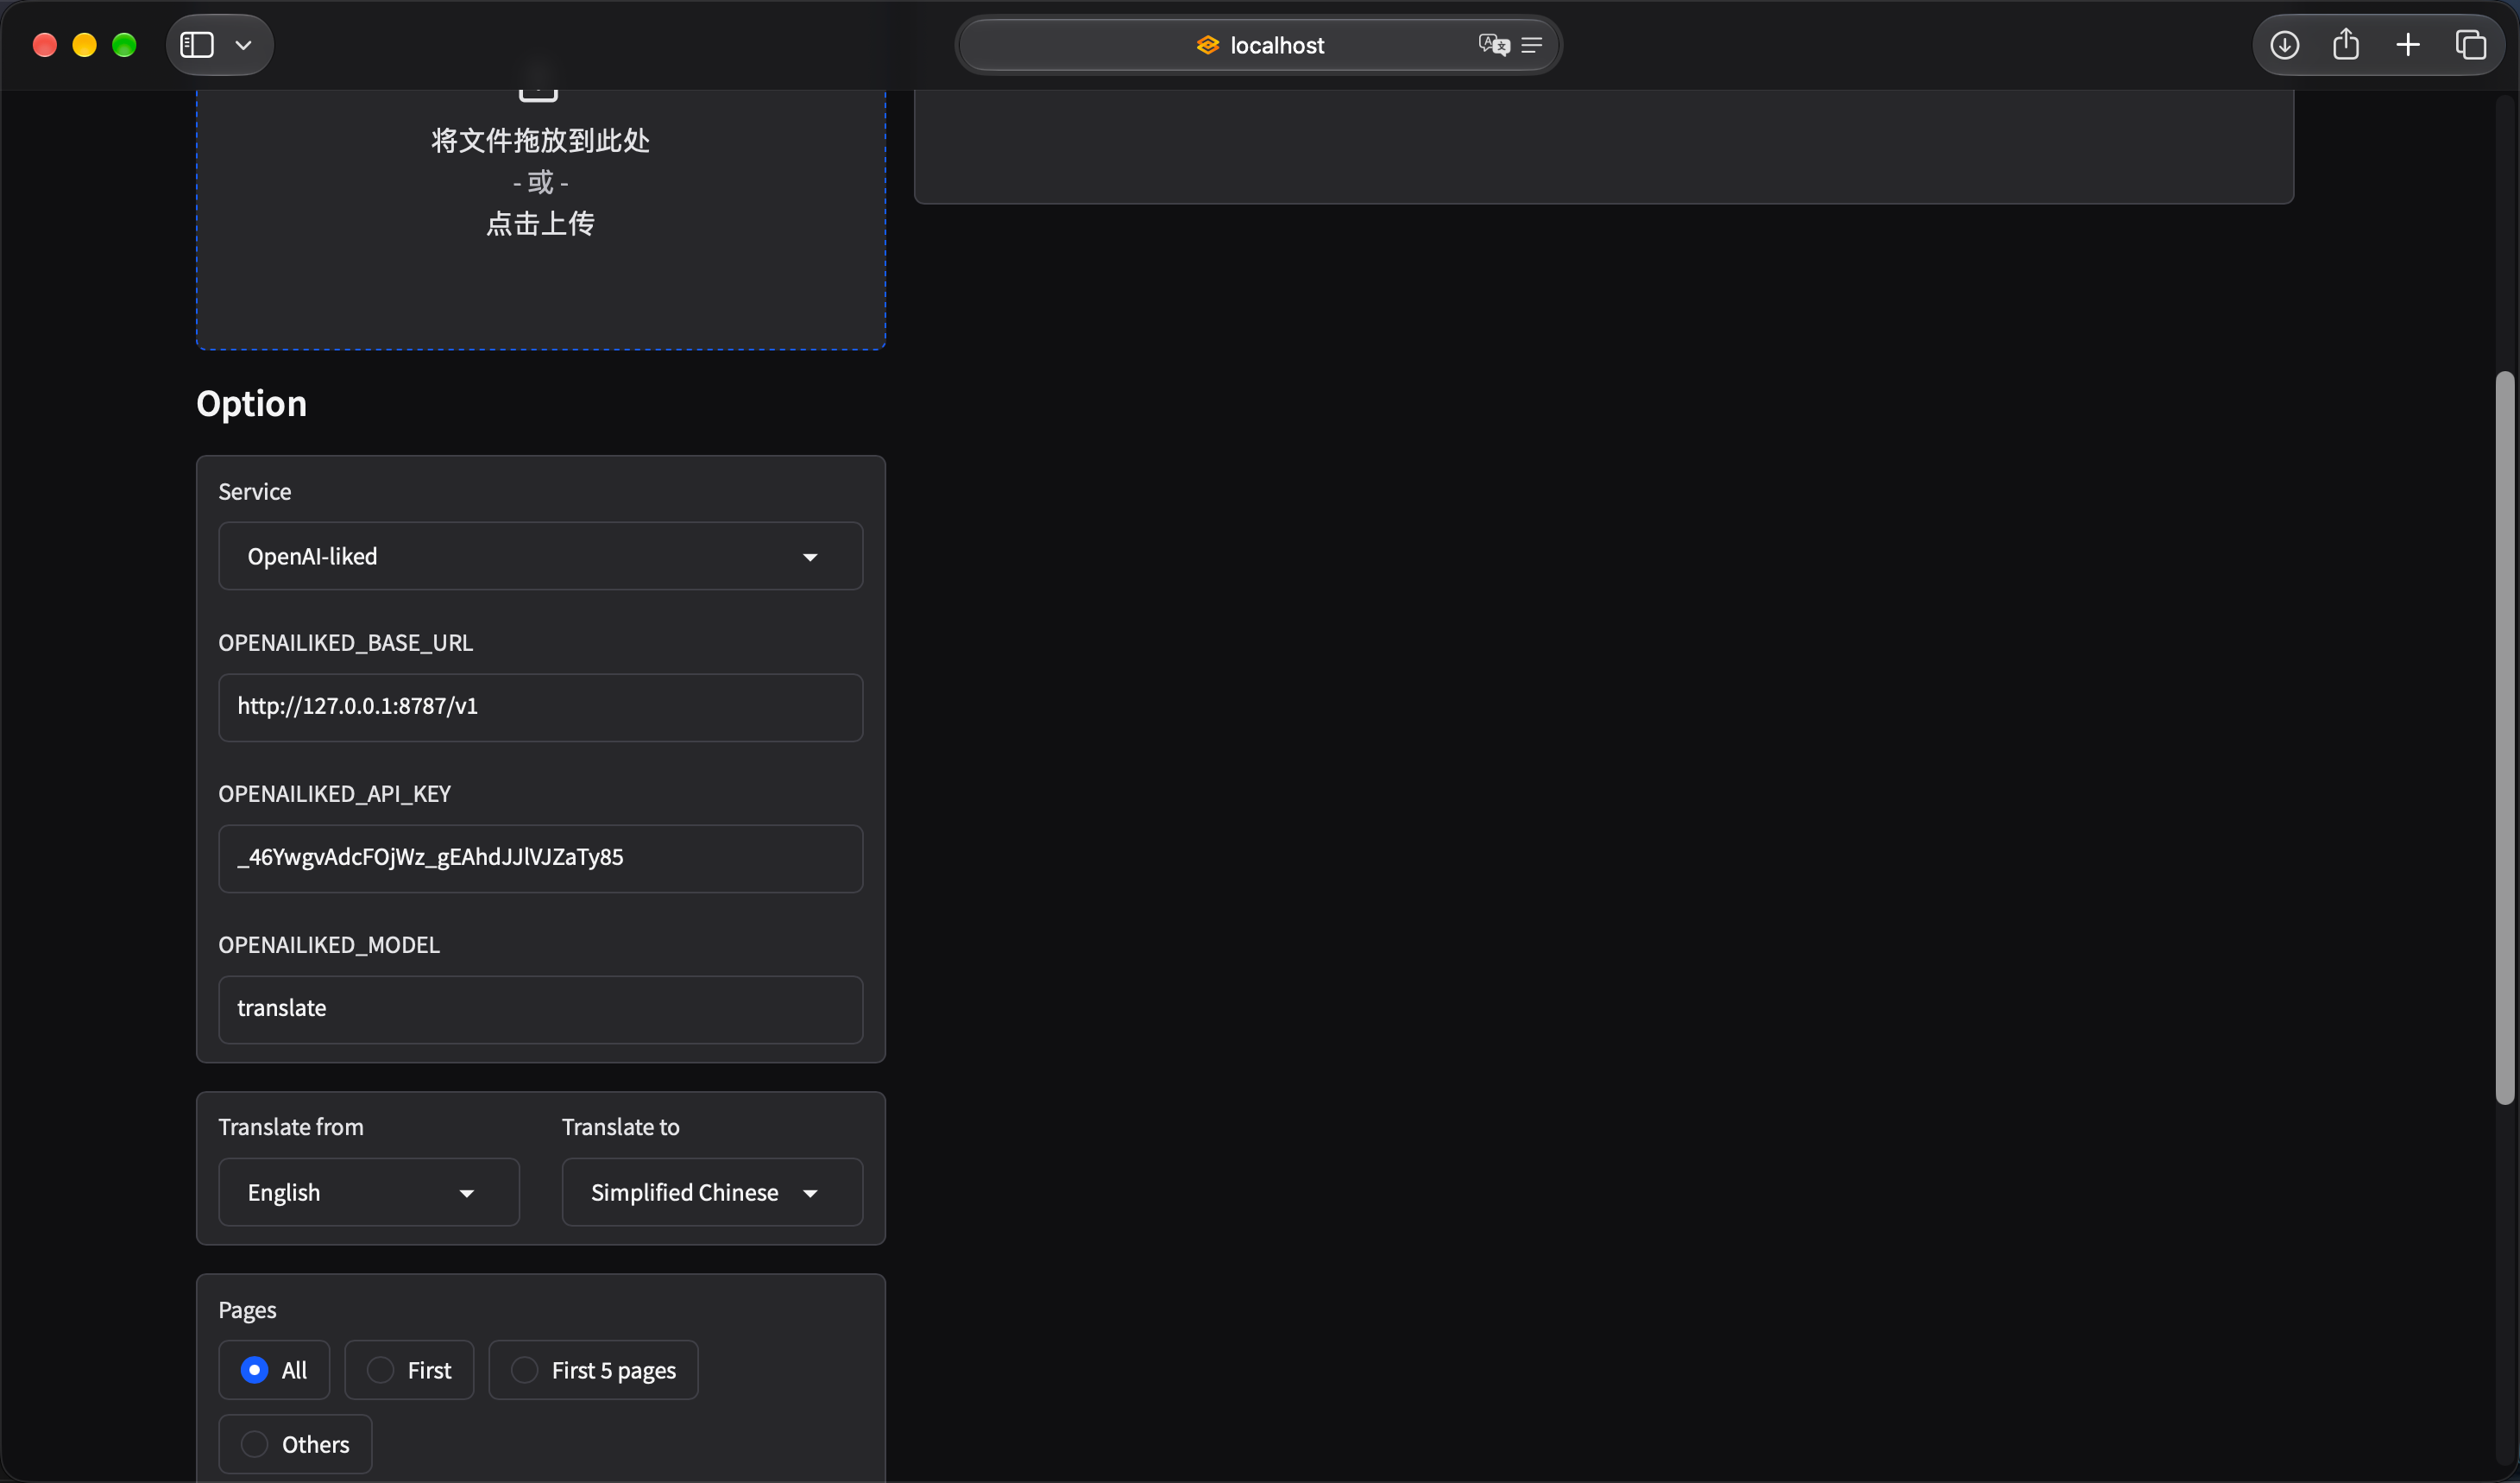
这里我用的是openai-like的接口,可以看到这里并没有openrouter要求的几项参数。那么我们直接写一个转换网关,这里加一个模仿agent的请求,项目地址:https://github.com/silenzio111/agy-token
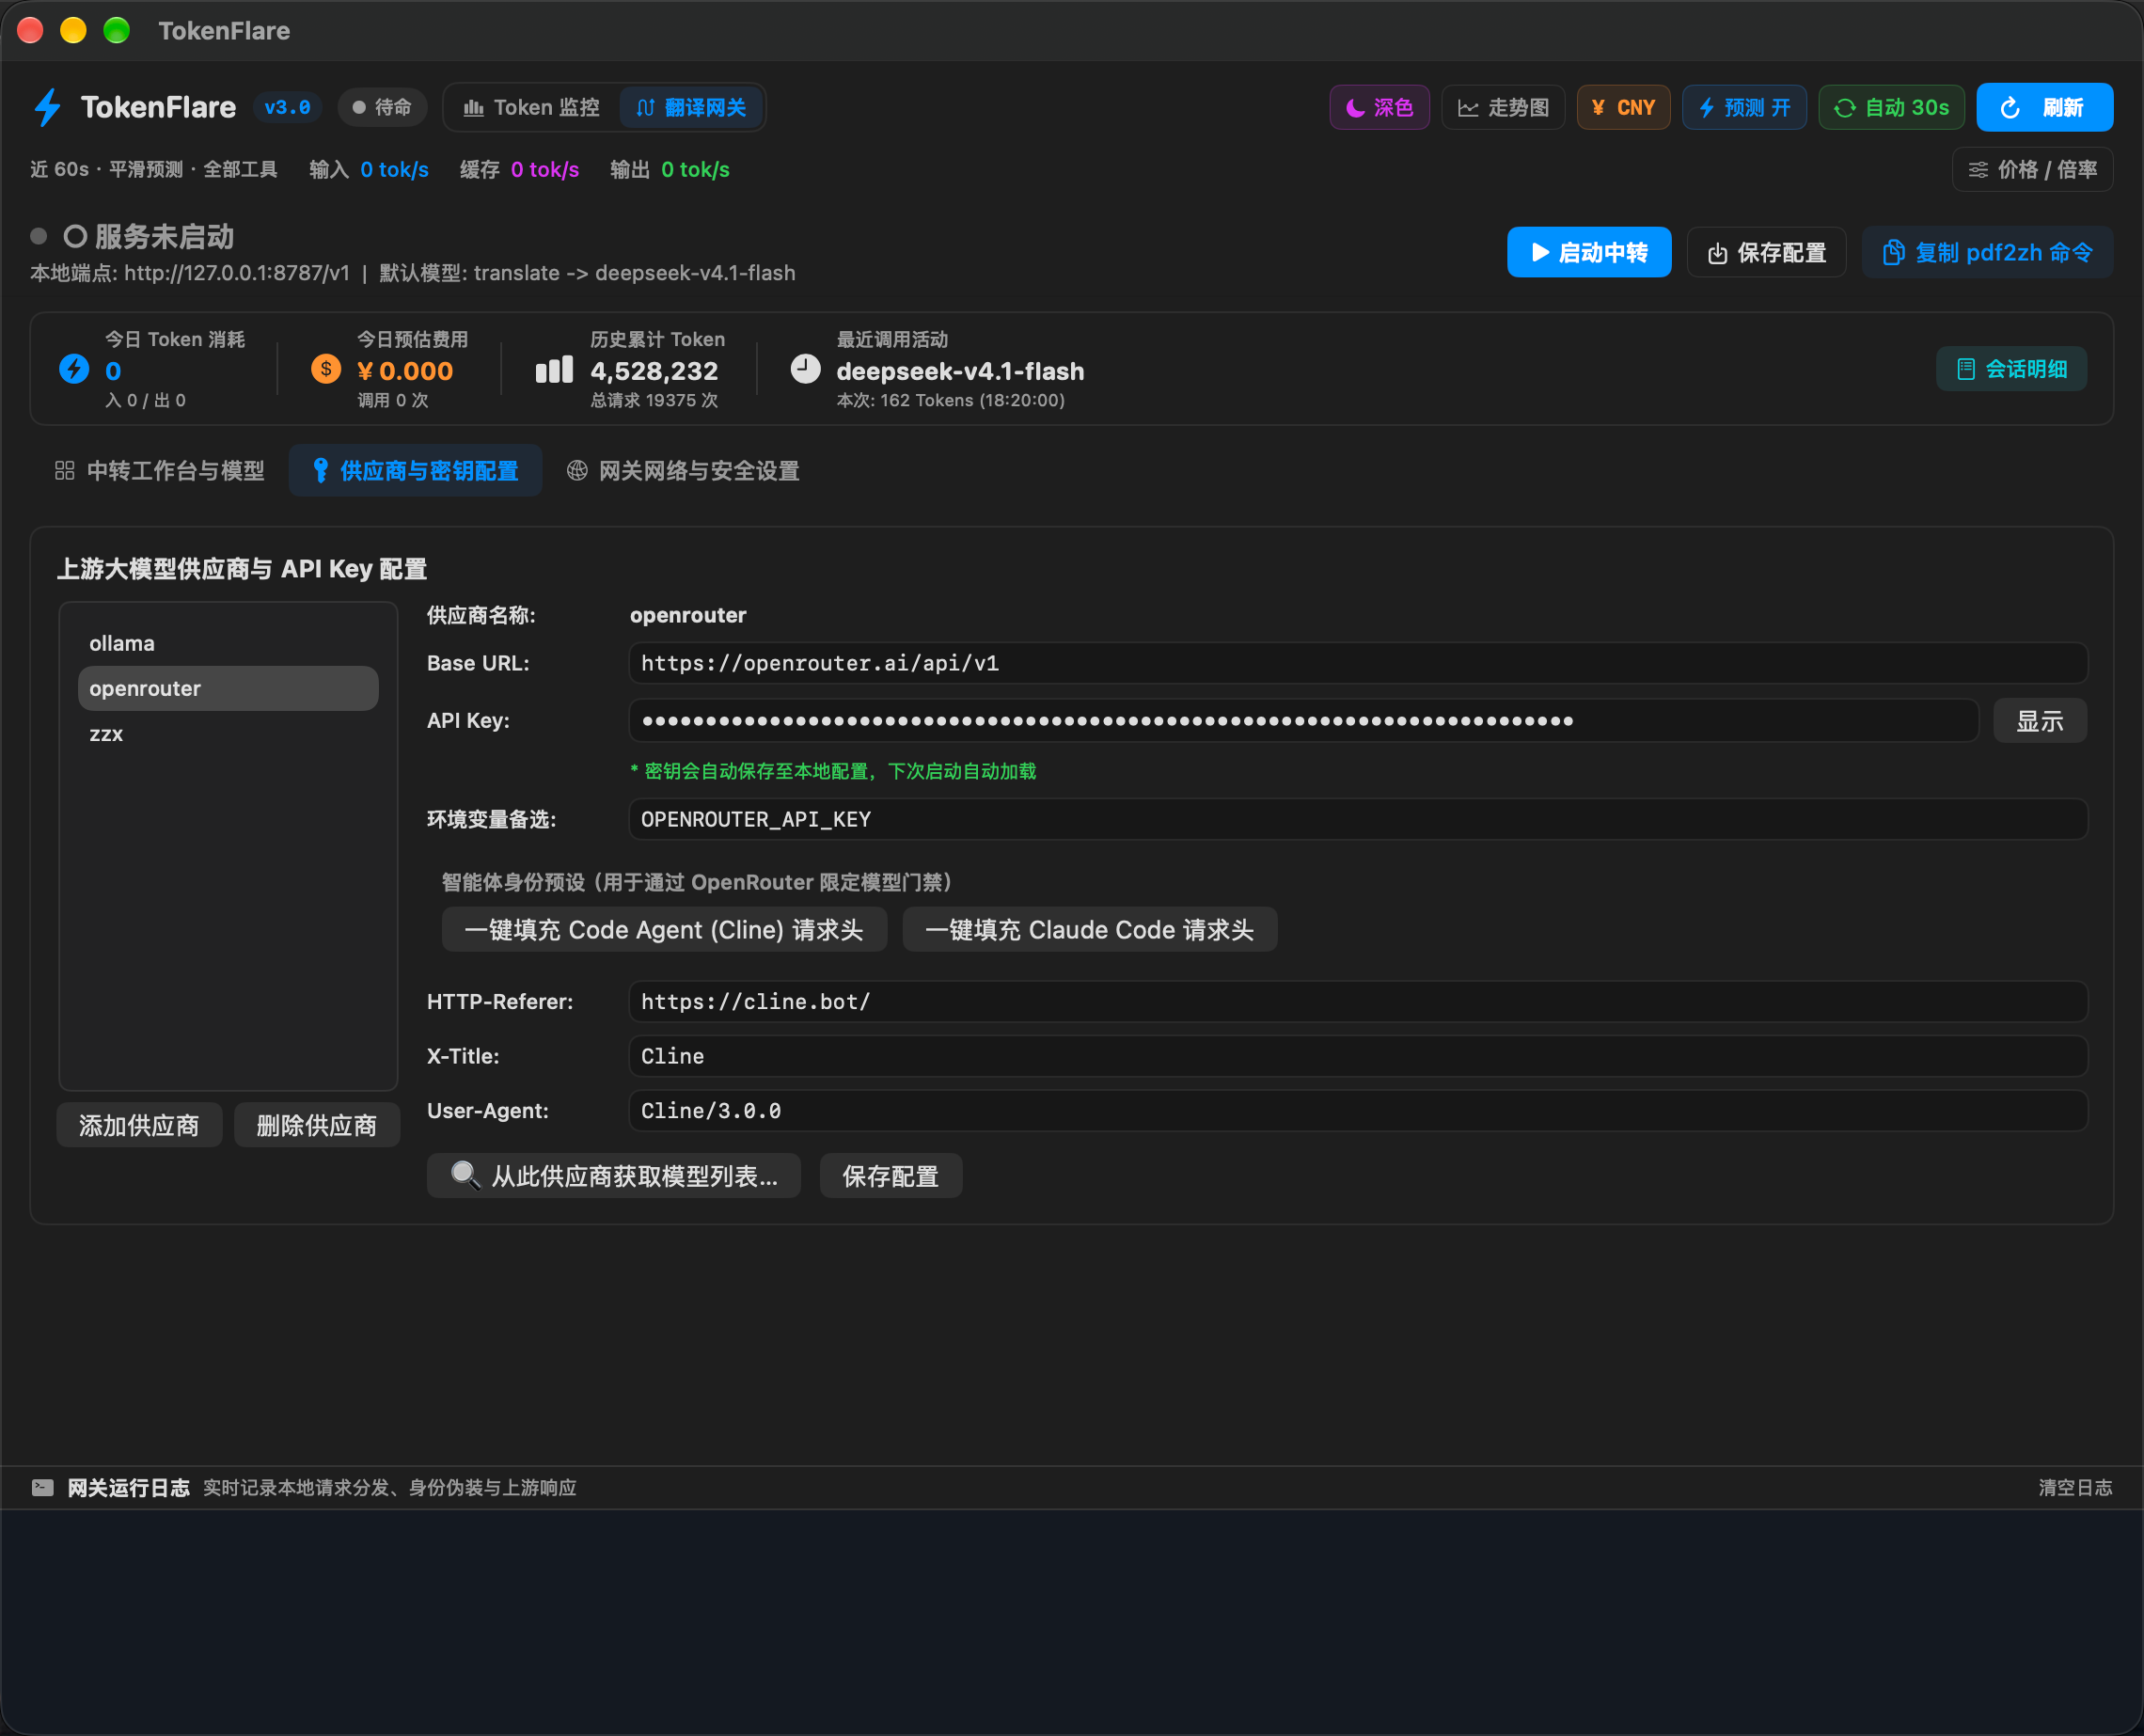
tips:openrouter对于每个0余额的用户,每天有1000次的调用限制,虽然不多,但是实测下来可以翻译一份50页左右的论文。如果接入其他的便宜的供应商,翻译的价格可以做到非常低。
已完成翻译的书籍
我会不断更新我已经翻译好的书籍上传到我的网站上,可以在线浏览。
见:
https://silenzio111.github.io/long/books/
网页实时翻译
这样的网关也可以提供给网页翻译插件,由它来提供网页的沉浸式翻译:
我使用的是沉浸式翻译这个插件,自带的翻译服务经常遇到报错的现象(可能是故意让你交钱充会员)。但是我们已经构建了一个翻译网关,那么直接使用它作为翻译服务就好了。这个插件还保留了自定义翻译服务的功能,还是比较良心的。
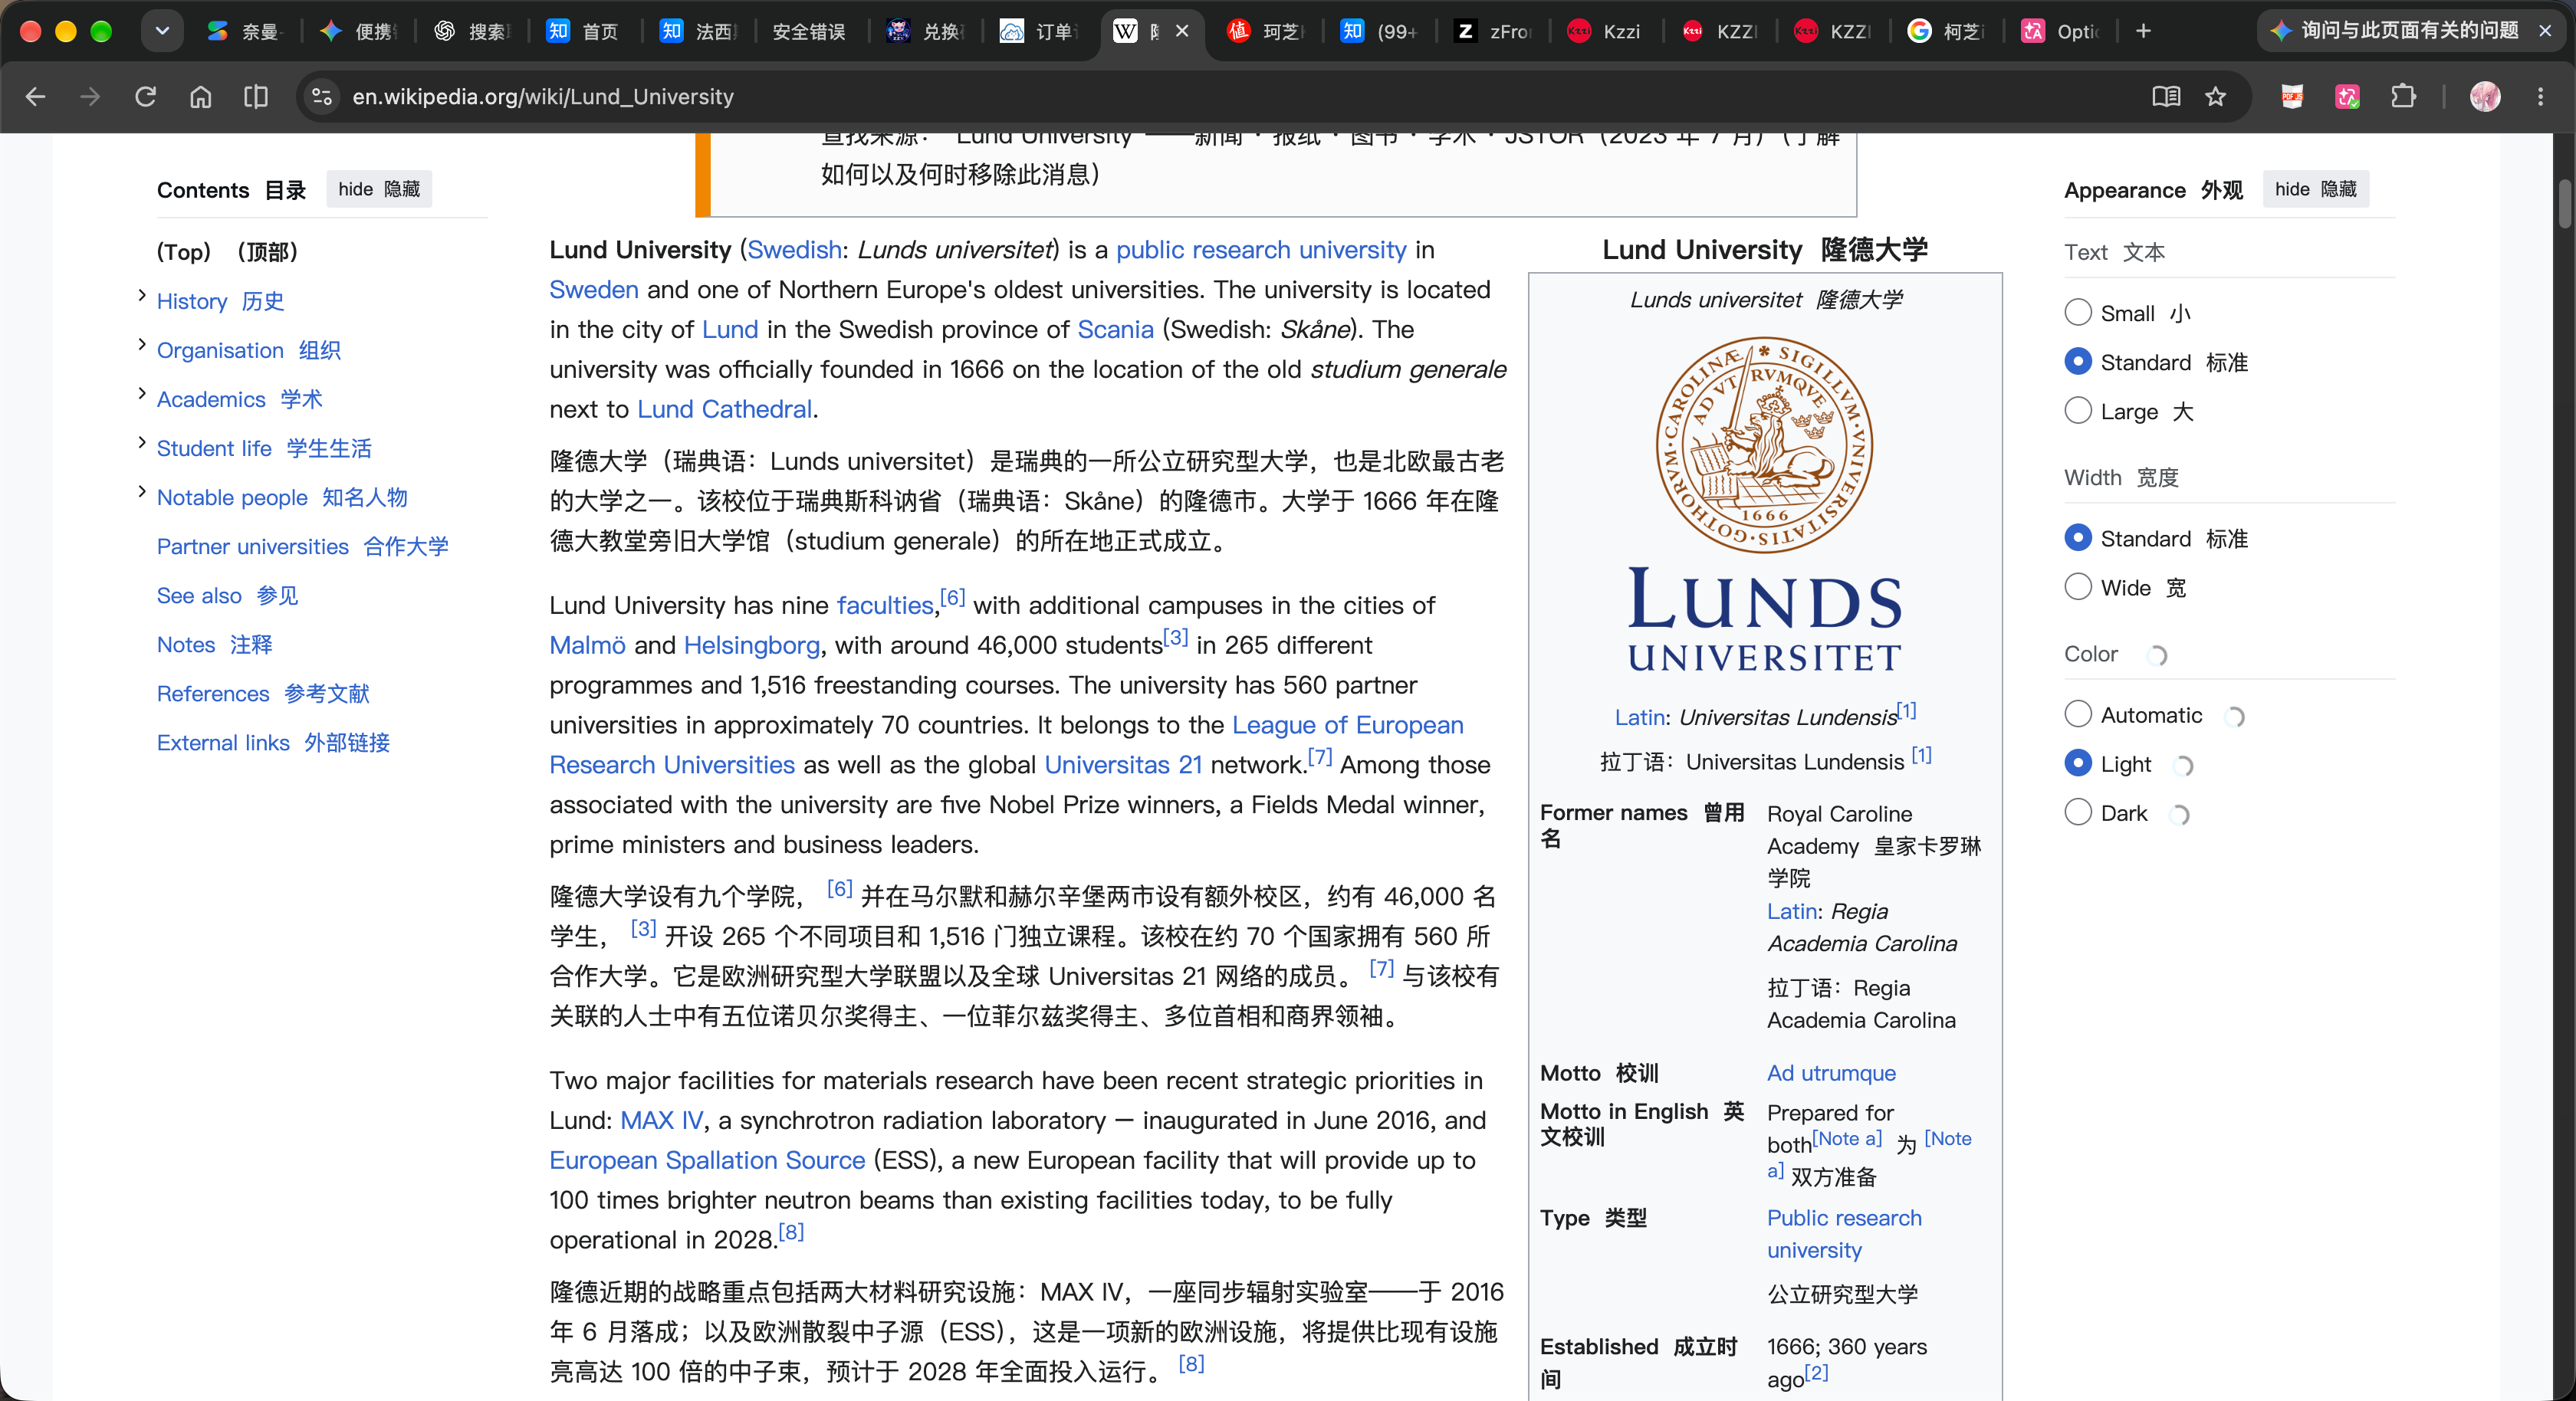
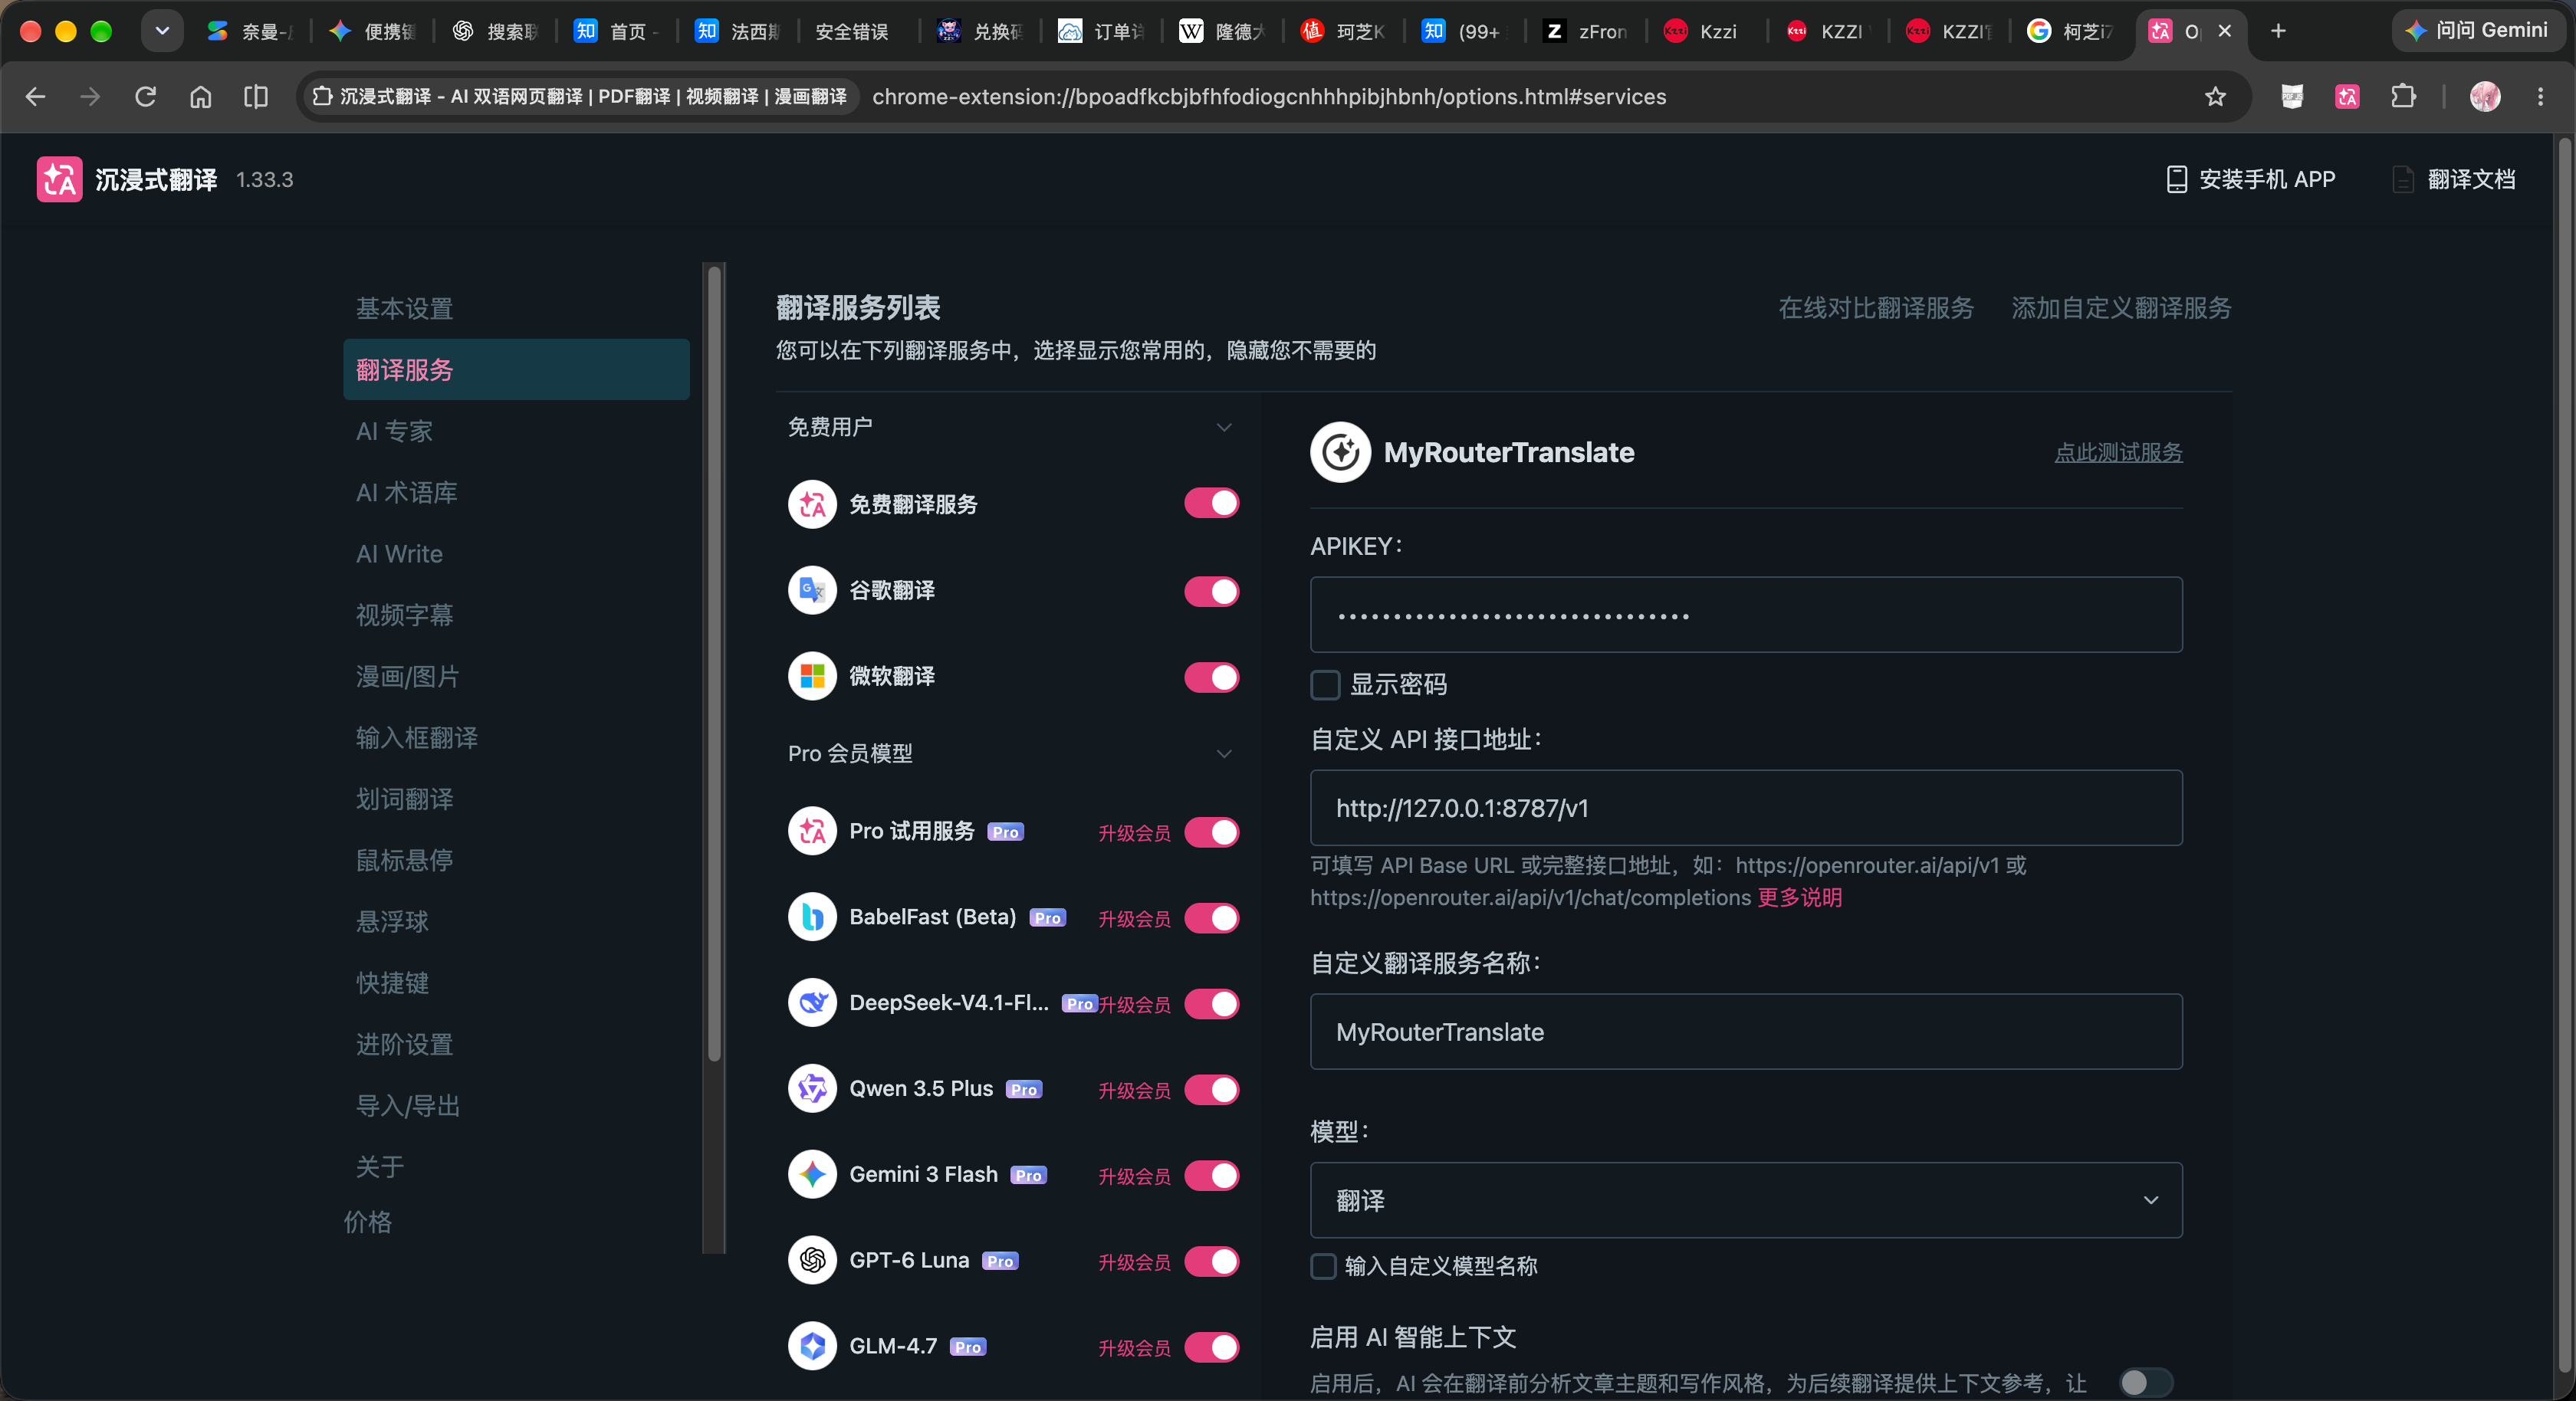 可以看到,效果非常不错:
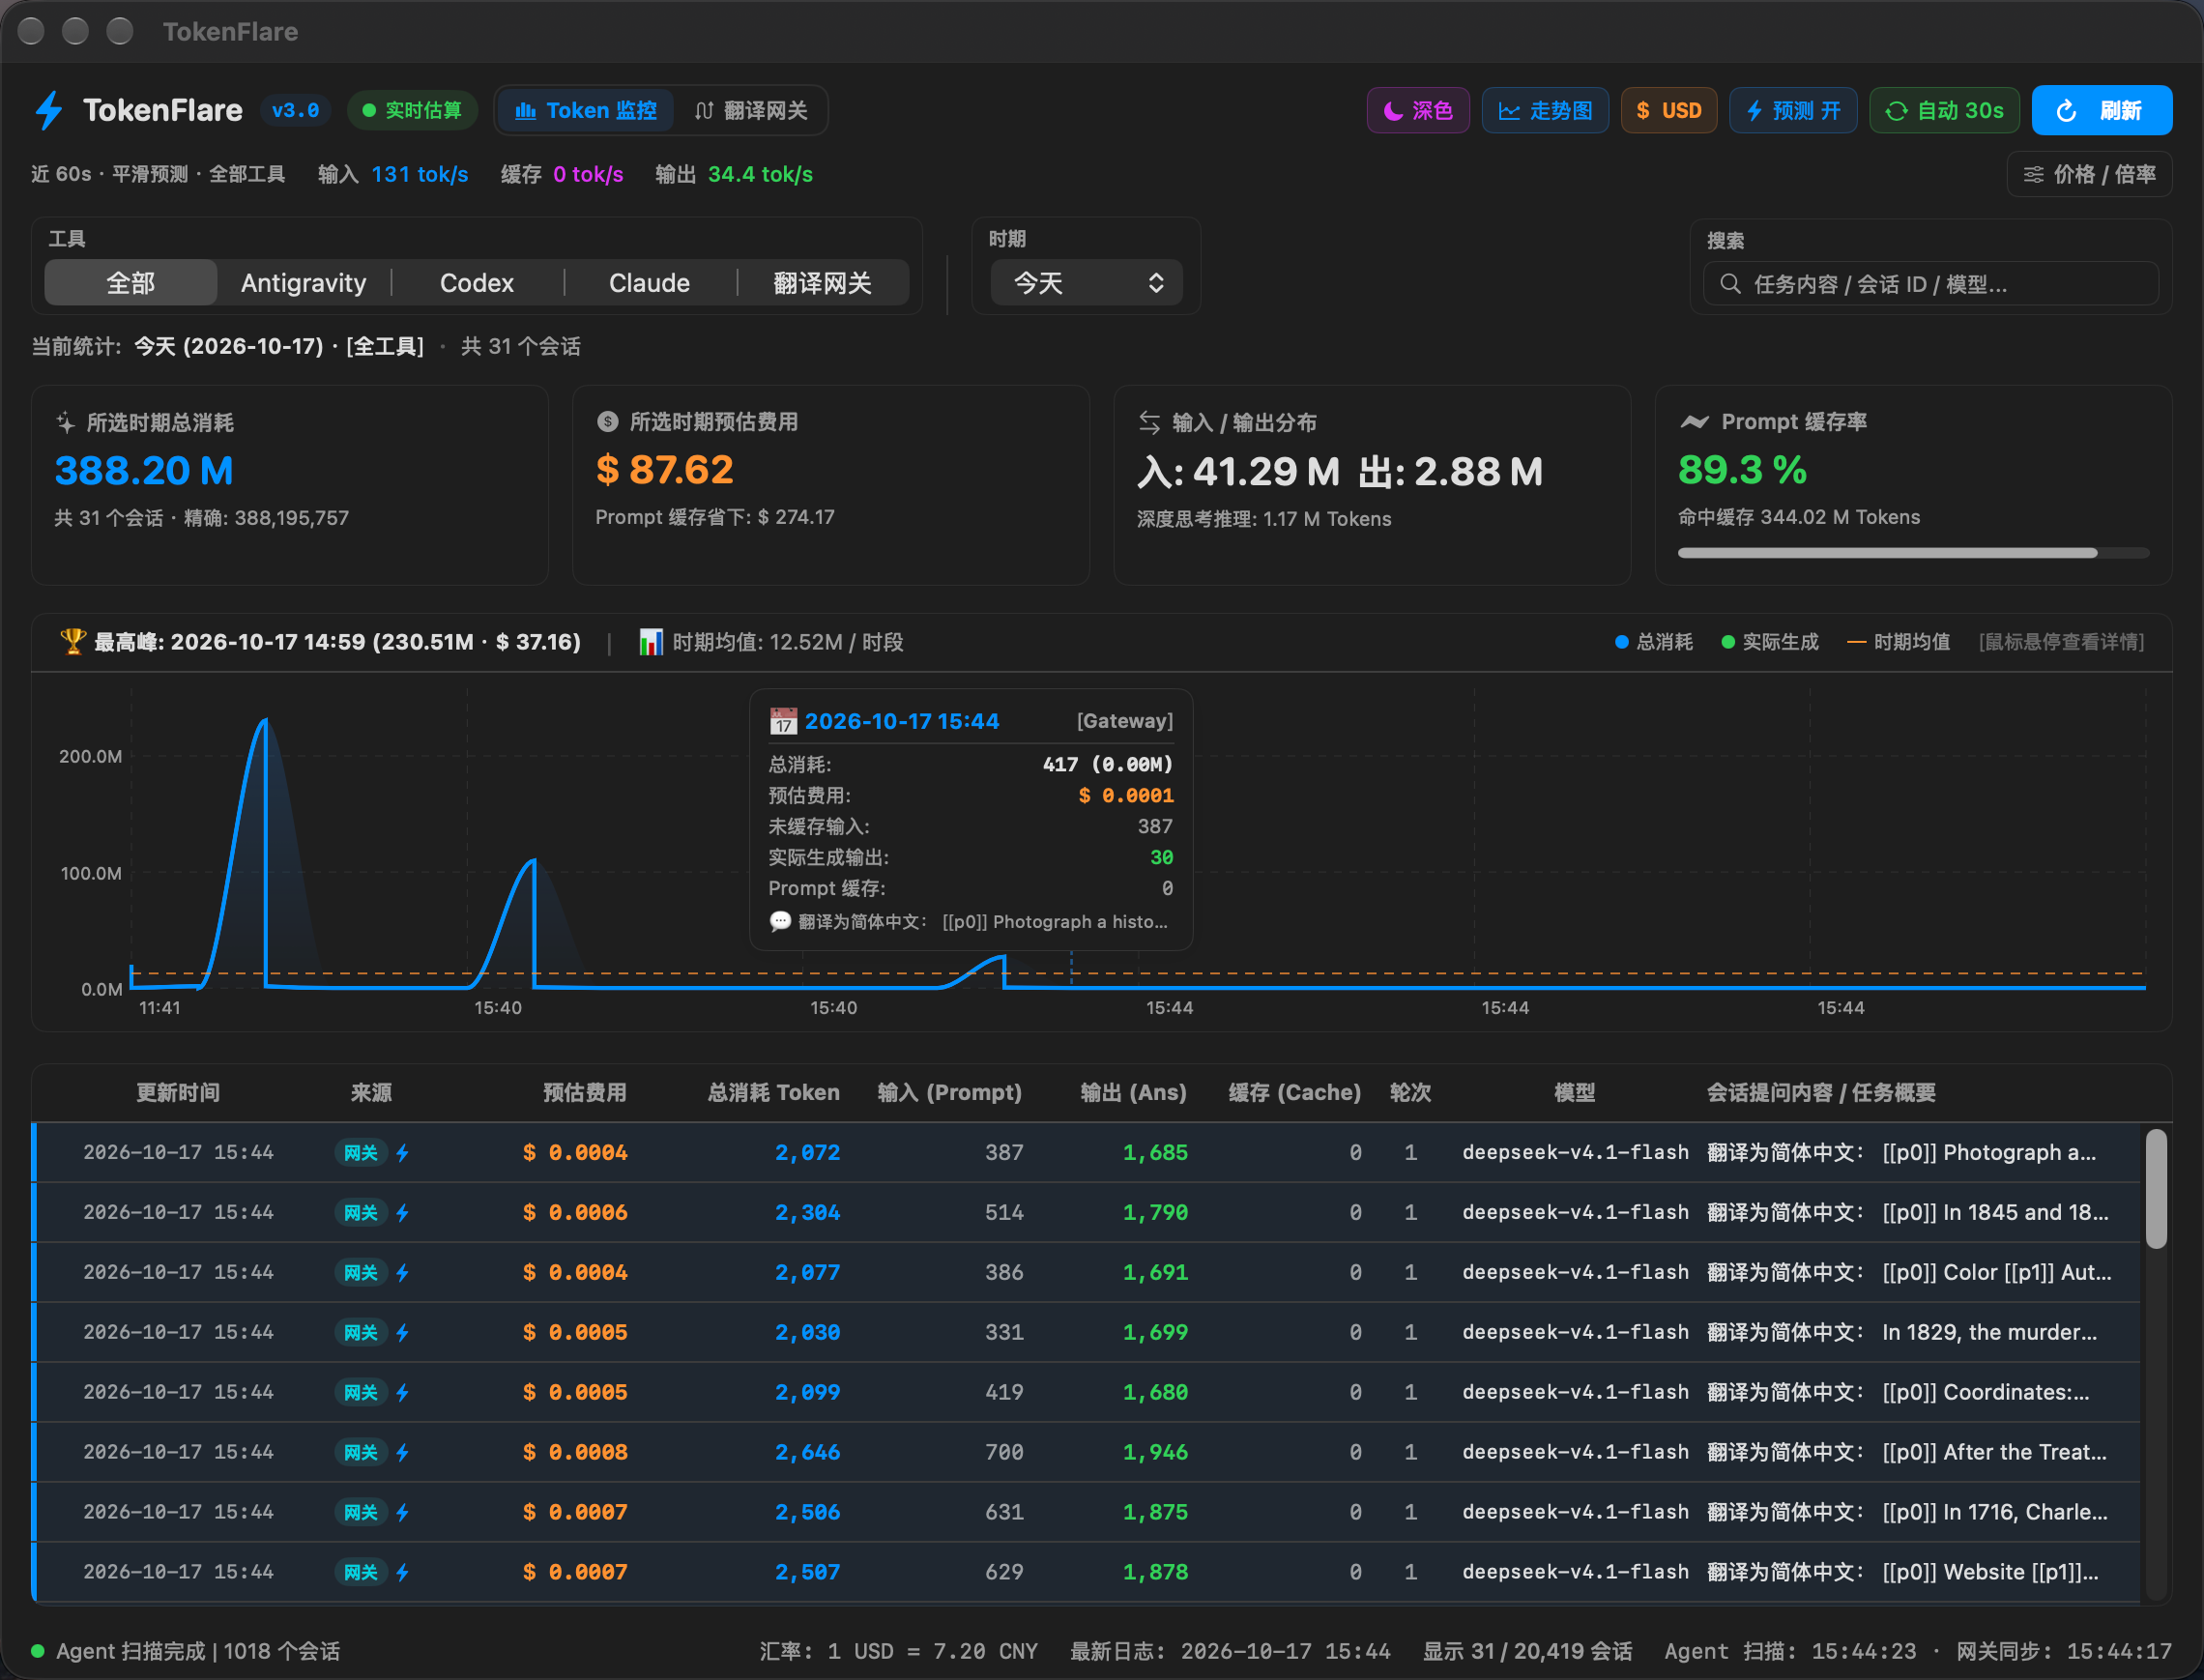
这里我们就能侦测到翻译服务运行的状况
后面打算优化一下pdfmathtranslate
pdfmathtranslate 还是有一些缺点的:
- 排版格式偶尔还是存在bug,对于bullet points的内容存在一些排版不适配的情况
- 翻译出来的中文区域之间有空隙,没有排版美感
- 这个翻译项目没有规定术语表,导致术语会出现偏移的现象,A在前文还是A的说法,在后文就变了